ノンパラメトリック検定の選び方完全ガイド!t検定との違いと使い分け
データ分析や論文執筆の現場において、「収集したデータが正規分布に従っていない」「サンプルサイズが小さくて前提条件を満たせない」「5段階評価のアンケート結果をどう検定すべきか」といった判断に迷う場面は少なくありません。母集団の分布に特定の仮定を置かないノンパラメトリック検定は、医療統計からマーケティングリサーチまで幅広く用いられる強力な解析手法です。
しかし、現場では「困ったらノンパラメトリックを選べば安全」という誤った思い込みや、t検定との使い分け基準の曖昧さによる分析エラーが後を絶ちません。本稿では、主要なノンパラメトリック検定の仕組み、パラメトリック検定との決定的な相違点、そして実務で迷わないための選択基準を徹底解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:ノンパラメトリック検定は正規分布を仮定せず、主に順位情報を用いて群間比較を行うため、歪んだデータや順位尺度に最適。
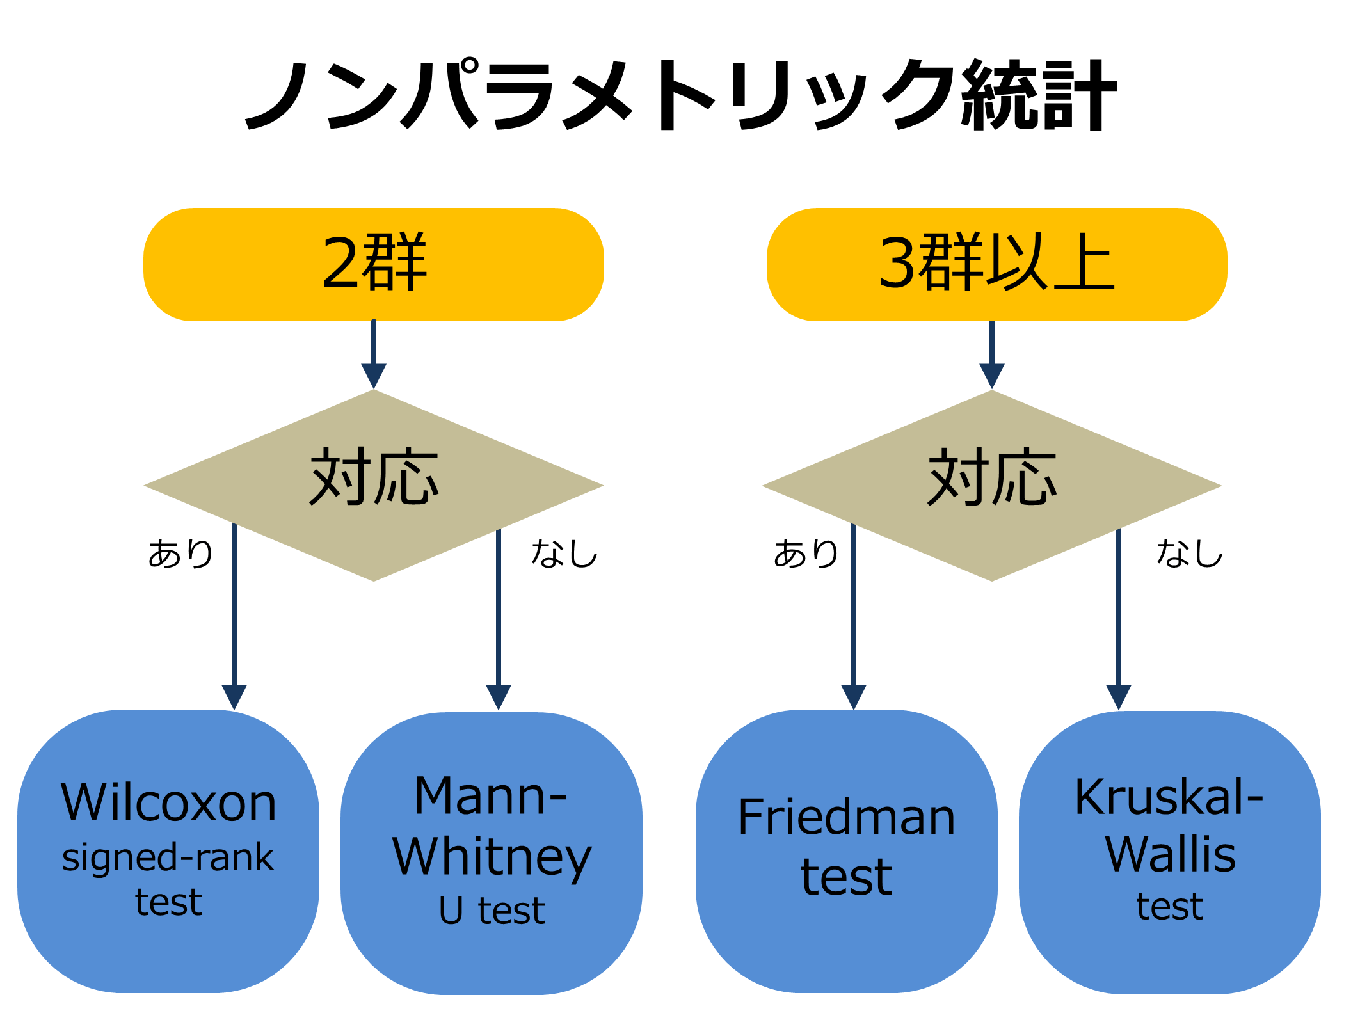
- 要点2:「2群の独立・対応」「3群以上の独立・対応」というデータ構造に応じて、マン・ホイットニーのU検定やクラスカル・ウォリス検定などを厳密に選定する必要がある。
- 要点3:シャピロ・ウィルク検定などの正規性検定だけに頼らず、サンプルサイズやQ-Qプロット、データの尺度水準を総合判断して検定手法を決定することが解析の妥当性を担保する。
【2026年最新】パラメトリック検定との違いと使い分けの絶対原則
統計的仮説検定の第一歩は、扱うデータに対してパラメトリック検定を適用すべきか、それともノンパラメトリック検定を適用すべきかを見極めることです。この2つのアプローチには、前提となる数学的条件と計算ロジックに根本的な違いが存在します。
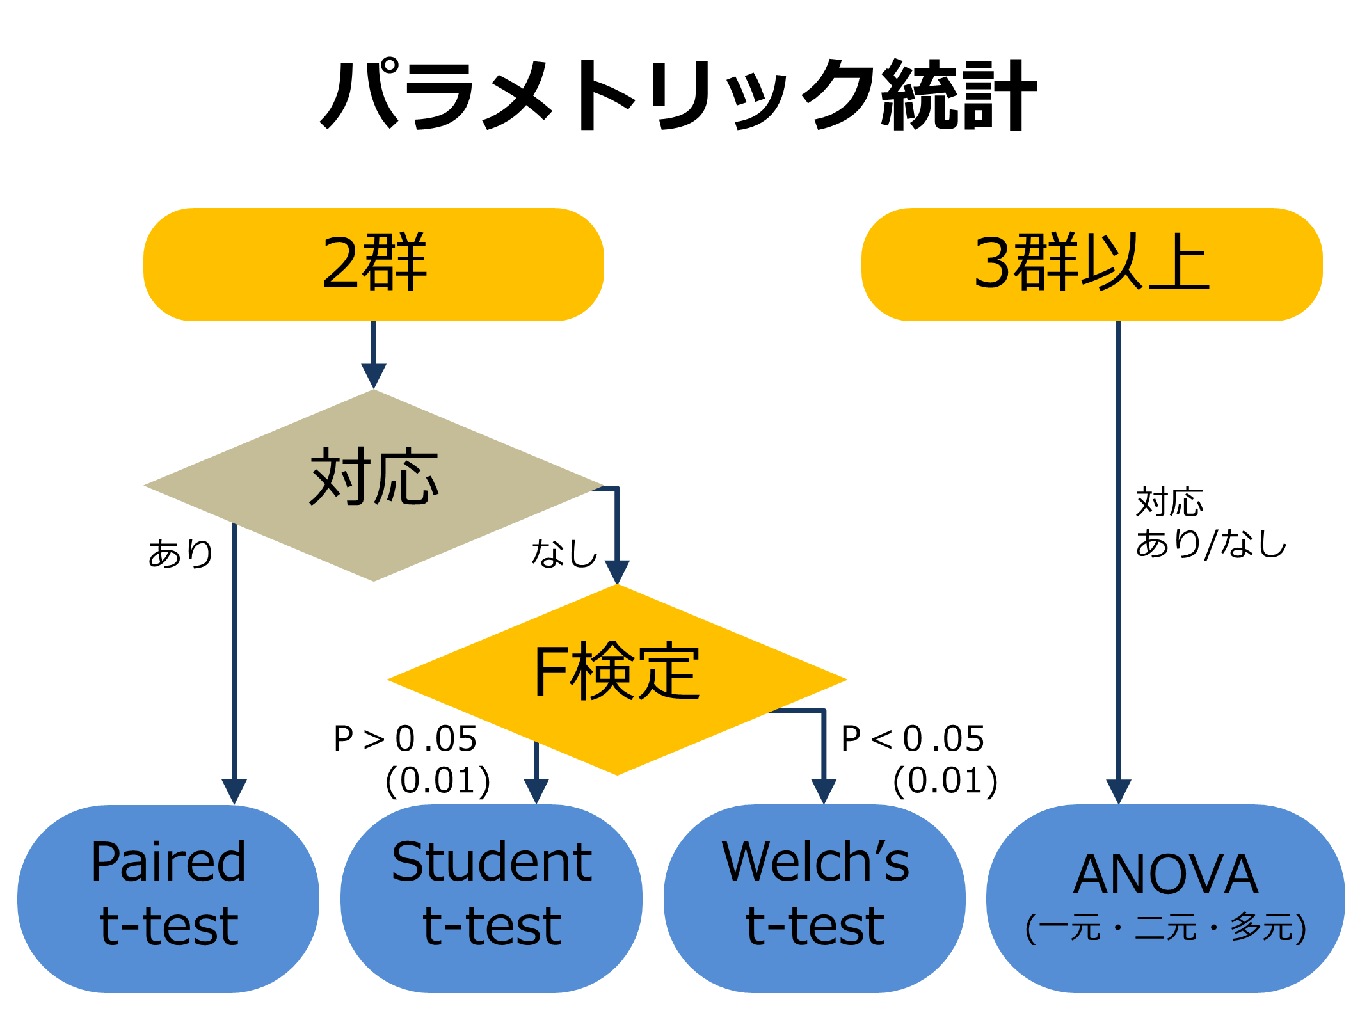
パラメトリック検定(Studentのt検定やWelchのt検定など)は、母集団が正規分布(左右対称の釣鐘型カーブ)に従っていることを大前提とします。データの「平均値」と「分散(標準偏差)」という要約統計量を用いて差の有無を判定するため、正規分布の前提が満たされている場合には統計的検出力(真の差を検出する力)が極めて高くなります。
一方でノンパラメトリック検定は、母集団の特定の分布形状を仮定しません。測定された数値をそのまま計算に使うのではなく、データを大きさ順に並べ替えた順位(ランク)に変換して解析を行います。そのため、以下のようなデータに対して極めて頑健(ロバスト)な検定結果を出力します。
- 外れ値(極端な値)が含まれるデータ:売上高、年収、医療検査値のように一部の突出した数値が平均値を大きく歪めてしまう場合。
- 順位尺度(順序尺度)のデータ:「満足・普通・不満」などの評価尺度や、痛み・重症度のスコア、ランキング順位。
- 明確に左右非対称な分布のデータ:指数関数的に減少する経過時間や、ゼロ付近に偏った出現頻度データ。
尺度水準の観点から整理すると、間隔尺度や比率尺度で正規性が担保されている場合はパラメトリック検定を選択し、順位尺度や正規性が崩れた間隔・比率尺度ではノンパラメトリック検定を選択するのが統計学的な原則です。名義尺度のデータ(男女比、疾患の有無など)を比較する場合には、カイ二乗検定やフィッシャーの正確確率検定を用います。
代表的な統計的仮説検定の選び方|対応表で一目でわかる主要手法
統計的仮説検定の選択で迷った際は、「比較する群の数(2群か3群以上か)」と「データに対応関係があるか(独立した別々の対象か、同一対象の前前後比較か)」の2軸で整理すると明快に判断できます。
| 検定の目的・データ構造 | パラメトリック手法 | ノンパラメトリック手法 | 解析時の主要な着眼点 |
|---|---|---|---|
| 独立な2群の比較 (例:A群 vs B群) | 対応のないt検定 (Student / Welch) | マン・ホイットニーのU検定 (ウィルコクソン順位和検定) | 2群の分布の形状が同等であれば「中央値の差」の検定として解釈可能。 |
| 対応のある2群の比較 (例:投薬前 vs 投薬後) | 対応のあるt検定 (Paired t-test) | ウィルコクソンの符号付順位検定 | 前後の差(差分データ)を算出し、その差の順位と符号に基づいて判定。 |
| 独立な3群以上の比較 (例:低用量 vs 中用量 vs 高用量) | 一元配置分散分析 (One-way ANOVA) | クラスカル・ウォリス検定 (Kruskal-Wallis test) | 有意差が出た場合は、多重比較法(Bonferroni補正付きDunn検定など)へ進む。 |
| 対応のある3群以上の比較 (例:治療前・1週後・4週後) | 反復測定分散分析 (Repeated Measures ANOVA) | フリードマン検定 (Friedman test) | 個体内の経時変化や複数条件の順位変動を一括して評価。 |
| 質的データの比率比較 (例:有効・無効の割合) | (該当なし) | カイ二乗検定 (分割表検定) / フィッシャー直接確率 | 期待度数が5未満のセルが20%以上ある場合はフィッシャーの正確確率検定を適用。 |
特に実務で最も多用されるのが、独立2群を比較するマン・ホイットニーのU検定(Mann-Whitney U test)です。これは数学的にウィルコクソン順位和検定(Wilcoxon rank-sum test)と同義であり、2群のデータをプールして昇順に並べ、各群の順位合計に基づいて有意確率を算出します。
【実態検証】データ解析の現場で頻発する誤解と「正規性の検定」の罠
データ解析の現場や学術コミュニティにおいて、最も頻繁に議論され、かつ誤用が多いのが正規性の検定(シャピロ・ウィルク検定:Shapiro-Wilk test)の扱いです。多くの初学者が「シャピロ・ウィルク検定でp > 0.05(正規性を棄却できない)だったからt検定を使う」「p < 0.05だったからノンパラメトリックを使う」という機械的な二者択一に陥っています。
しかし、国内外の統計専門家や学術誌の査読者は、この自動化された手法選択に強い警鐘を鳴らしています。そこにはサンプルサイズに依存する統計的性質の罠が存在するためです。
1. サンプルサイズが小さい場合の盲点(偽陰性のリスク)
各群のサンプルサイズが小さい場合(例えばn = 5〜15程度)、シャピロ・ウィルク検定の検出力は極めて低くなります。母集団の分布が実際には激しく歪んでいたとしても、データ数が少なすぎるために統計的有意差が出ず、p値が0.05を上回ってしまいます。「正規性検定をパスした」と誤認してt検定を実行すると、偽陽性率(第1種の過誤)が跳ね上がり、誤った結論を導く危険があります。
2. サンプルサイズが非常に大きい場合の盲点(過剰な検出力)
逆に各群n = 500〜1,000を超えるような大規模データでは、シャピロ・ウィルク検定は極めて高い検出力を持ちます。正規分布からわずかに外れただけの臨床的・実務的に無視できる微小な歪みであっても、p < 0.001となって「正規分布ではない」と判定されます。しかし、大標本では中心極限定理が働くため、平均値の標本分布自体は正規分布に近似され、t検定を問題なく適用できます。ここで無理にノンパラメトリック検定を選択すると、かえって検定力が損なわれます。
したがって、手法選択は正規性検定のp値のみで機械的に決定してはなりません。ヒストグラムやQ-Qプロット(Quantile-Quantile plot)を作成して視覚的に歪みや外れ値を確認し、先行研究の知見やデータの発生メカニズムを総合的に考慮して判断するのが現代統計解析の標準手順です。
順位尺度データ解析の実践|EZR解析手順と代表値の正しい記載法
日本の医療統計や学術研究でデファクトスタンダードとなっている無料統計ソフトEZR(Easy R)を用いた、ノンパラメトリック検定の具体的な操作手順と論文・レポートへの記載ルールを解説します。
EZRにおける主要な解析手順
- マン・ホイットニーのU検定を実行する場合: メニューバーの「統計解析」→「ノンパラメトリック検定」→「2群の比較(Mann-WhitneyのU検定)」を選択。目的変数(連続量・順位スコア)と群別変数(2値)を指定して実行します。
- ウィルコクソンの符号付順位検定を実行する場合: 「統計解析」→「ノンパラメトリック検定」→「対応のある2群の比較(Wilcoxonの符号付順位検定)」を選択。前後2つの変数を指定して実行します。
- クラスカル・ウォリス検定を実行する場合: 「統計解析」→「ノンパラメトリック検定」→「3群以上の比較(Kruskal-Wallis検定)」を選択。多重比較が必要な場合は自動出力される調整済みp値を確認します。
代表値と散布度の正しい表記ルール
論文や報告書を作成する際、パラメトリック検定では「平均値 ± 標準偏差(Mean ± SD)」を記載しますが、ノンパラメトリック検定を採用した場合は「中央値 [四分位範囲](Median [IQR : Interquartile Range])」または「中央値 [最小値 - 最大値]」を記載するのが鉄則です。
外れ値の影響を強く受けているデータに対して平均値と標準偏差を併記すると、データの中心的位置を正しく描写できず、査読者や読者から解析の妥当性を疑われる原因となります。
【プロの結論】おすすめできる人・慎重になるべき人の判断基準
ノンパラメトリック検定は万能の免罪符ではありません。メリットとデメリットを正しく理解した上で、自身の研究デザインやデータ特性に合わせて採用すべきか判断してください。
ノンパラメトリック検定を積極的に選択すべきケース
- データが順位尺度・リッカート尺度の場合:アンケートの5段階評価スコアや、医学的な重症度分類スコアなど、等間隔性が保証されていないデータ。
- 明確な外れ値や強い歪みがある場合:除外できない正当な外れ値が存在し、対数変換などのデータ変換を行っても正規分布に近づかないデータ。
- 各群のサンプルサイズが小さく(n < 20)、母集団の正規性が不明な場合:過去の知見からも正規分布を仮定することが難しい探索的初期データ。
パラメトリック検定を検討すべき(ノンパラに慎重になるべき)ケース
- サンプルサイズが十分に大きく(各群n > 30〜50以上)、検出力を最大化したい場合:正規分布に近いデータに対してノンパラメトリック検定を用いると、パラメトリック検定に比べて有意差を検出する力(検定力)がわずかに低下(漸近相対効率で約95%程度)します。
- 多変量解析や共変量の調整を予定している場合:重回帰分析や共分散分析(ANCOVA)など、他の交絡因子を調整する高度な統計モデルにスムーズに接続したい場合。
- 平均値の差そのものに臨床的・実務的な意味がある場合:医療費の総額や製造ラインの平均歩留まりなど、順位ではなく実数値の差が直接的な意思決定に関わる指標。
解析結果の信頼性を担保するためには、「p値が有意にならなかったから検定手法をノンパラメトリックに変える」といったp-hacking(有意性操作)は絶対に避けなければなりません。データ収集前の研究計画書(プロトコル)の段階で、主要評価項目の検定方針を明確に定めておくことが最も誠実な解析アプローチです。
【ノン パラメトリック 検定】に関するよくある質問(FAQ)
Q1:サンプルサイズが極端に小さい場合(各群n=3など)でもマン・ホイットニーのU検定は使えますか?
A1:数学的に計算自体は可能ですが、統計的な有意差(p < 0.05)を得ることは困難です。マン・ホイットニーのU検定では、群サイズが(3, 3)の場合に取り得る最小のp値は1/20(0.05)であり、両側検定で5%水準を有意にするには最低でも各群4例以上(または3例と6例など)の標本が必要です。極小サンプルでは検定手法の選択以前に標本サイズの設計が課題となります。
Q2:アンケートの5段階評価(リッカート尺度)には必ずノンパラメトリック検定を使うべきですか?
A2:厳密な統計理論上は順位尺度であるためノンパラメトリック検定(マン・ホイットニーのU検定など)が推奨されます。ただし、心理尺度などで複数の設問項目を合算して合計得点(合成スコア)を作成し、かつサンプル数が十分に大きい場合は、間隔尺度とみなしてt検定や分散分析を適用する慣例も広く認められています。単一の設問を比較する場合はノンパラメトリック検定を用いるのが最も安全です。
Q3:中央値が全く同じ2群間で、マン・ホイットニーのU検定が有意(p < 0.05)になることはありますか?
A3:はい、十分に起こり得ます。マン・ホイットニーのU検定は「中央値そのものを直接比較する検定」ではなく、「一方の群から無作為に抽出した値が、もう一方の群の値より大きくなる確率(順位和の分布)」を評価する検定です。2群の中央値が同一であっても、全体の分布の偏りや裾野の広がり方が異なる場合、順位和に有意な偏りが生じてp < 0.05となることがあります。
Q4:名義尺度(カテゴリデータ)の比較でノンパラメトリック検定とカイ二乗検定はどう違いますか?
A4:カイ二乗検定も広義のノンパラメトリック手法に含まれますが、順序のない名義尺度(例:「男性・女性」「A型・B型・O型・AB型」など)の割合の差を検定する際に用います。一方、狭義のノンパラメトリック検定(マン・ホイットニーやクラスカル・ウォリスなど)は、「順位・順序情報」を持つ数値やスコアを比較する際に適用します。
まとめ:データの本質を見極めて最適な検定手法を選択しよう
ノンパラメトリック検定は、正規分布の前提が崩れたデータや順位尺度データに対して、極めて頑健かつ安全な検証結果をもたらす不可欠な解析手法です。
t検定をはじめとするパラメトリック検定との使い分けにおいては、シャピロ・ウィルク検定のp値だけに依存するのではなく、データの尺度水準、サンプルサイズ、視覚的な分布形状を立体的に評価することが不可欠です。独立2群のマン・ホイットニーのU検定、対応2群のウィルコクソンの符号付順位検定、3群以上のクラスカル・ウォリス検定など、データ構造に合致した正しい検定手法を選択し、中央値と四分位範囲を用いた適切な要約を行ってください。 (出典: ノン パラメトリック 検定(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
